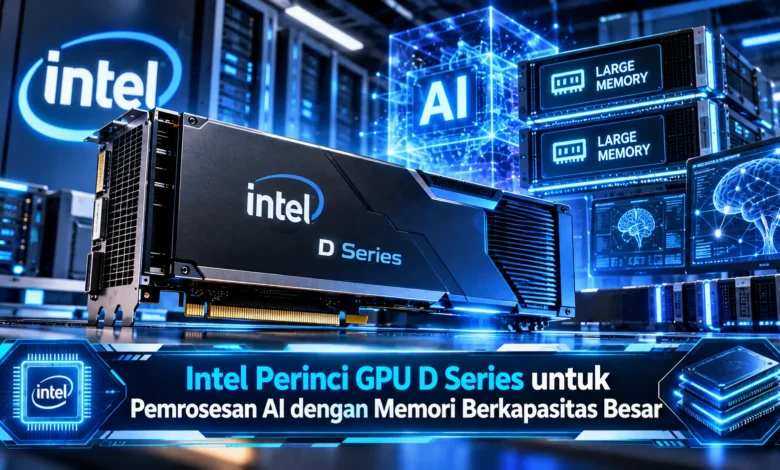
Intel memperkenalkan rincian terbaru GPU D Series sebagai solusi komputasi kecerdasan buatan yang dirancang untuk menangani pemrosesan AI dengan kebutuhan memori besar. Dalam ajang Open Compute Project Global Summit pada 12 Oktober 2026, perusahaan tersebut mengungkap kemampuan akselerator yang sebelumnya dikenal dengan nama kode Crescent Island. GPU berbasis arsitektur Xe3P ini menawarkan kapasitas memori LPDDR5X hingga 480 GB, bandwidth 1,5 TB/s, dan kemampuan komputasi hingga 1,3 petaflops FP8. Kehadirannya memperlihatkan strategi Intel dalam mengembangkan teknologi pusat data yang lebih efisien untuk menjalankan model AI generatif, layanan inferensi, dan sistem agentic AI.
Pengembangan GPU D Series sebagai Akselerator AI Pusat Data
Kemajuan ekosistem komputasi AI memperbesar permintaan perangkat keras yang dirancang untuk memproses sistem kecerdasan buatan kompleks secara semakin optimal. Menanggapi kebutuhan tersebut, Intel mengembangkan GPU D Series sebagai perangkat komputasi pusat data yang menekankan kapasitas memori. Akselerator terbaru ini sebelumnya dikenal dengan nama kode Crescent Island sebelum dimasukkan ke lini produk Intel GPU D Series. Berkat rancangan yang berorientasi pada inferensi, perusahaan menargetkan hadirnya solusi komputasi yang lebih fleksibel bagi perusahaan pengembang kecerdasan buatan.
Presentasi perusahaan dalam OCP Global Summit 2026 memberikan informasi lebih lengkap mengenai kapasitas memori GPU D Series. Berbeda dari kartu grafis konsumen, akselerator ini difokuskan pada pemrosesan model kecerdasan buatan. Inferensi sendiri merupakan proses menghasilkan keluaran dari model kecerdasan buatan. Dalam penerapan sehari-hari, layanan chatbot menggunakan proses inferensi ketika merespons pertanyaan. Apabila layanan AI digunakan dalam skala besar, efisiensi perangkat keras semakin penting. Karena itulah, Intel menempatkan GPU D Series sebagai perangkat pendukung layanan AI perusahaan.
Spesifikasi Intel GPU D Series dengan Memori LPDDR5X hingga 480 GB
Fitur paling menonjol Intel GPU D Series adalah kapasitas LPDDR5X mencapai 480 GB. Dalam rancangan tersebut, Intel memanfaatkan teknologi memori LPDDR5X yang dirancang untuk efisiensi energi. Dukungan penyimpanan data sementara sebesar itu memungkinkan penempatan parameter jaringan neural. Tidak hanya menyediakan memori besar, perangkat ini mendukung bandwidth memori sebesar 1,5 terabyte per detik. Kecepatan akses memori tersebut memiliki pengaruh besar dalam memenuhi kebutuhan akses data model AI. Keseimbangan ruang penyimpanan dan kecepatan akses berpotensi membantu menjalankan model kecerdasan buatan yang membutuhkan banyak memori.
Tidak hanya mengandalkan kapasitas LPDDR5X, Intel GPU D Series menggunakan arsitektur Xe3P yang dikembangkan untuk akselerasi kecerdasan buatan. Akselerator ini menawarkan kemampuan puncak hingga 1,3 petaflops FP8. Presisi FP8 mengacu pada format numerik berpresisi rendah yang mendukung akselerasi model kecerdasan buatan. Pemanfaatan presisi rendah ini membantu mempercepat operasi yang kompatibel. Walaupun angka performanya tinggi, kemampuan puncak teoritis tidak selalu mencerminkan kinerja aplikasi nyata. Aspek yang memengaruhi kinerja meliputi ukuran model, pengaturan numerik, dan optimalisasi framework.
Mengapa Memori Besar Penting untuk Menjalankan Model AI
Dalam pengembangan AI modern, ketersediaan memori memiliki peranan utama karena data jaringan neural perlu diakses secara berulang. Model dengan parameter lebih banyak umumnya memerlukan memori lebih besar. Tidak hanya bobot jaringan neural, proses inferensi juga menggunakan ruang untuk cache. Salah satu contohnya adalah KV cache yang menyimpan informasi perhatian dari token sebelumnya. Apabila jumlah token yang diproses meningkat, kebutuhan memori menjadi semakin besar. Kebutuhan data sementara tersebut menjadi alasan penggunaan GPU dengan memori besar.
Dalam contoh sederhana, sebuah model AI dengan 70 miliar parameter membutuhkan sekitar 140 GB hanya untuk bobot FP16. Estimasi sederhana ini belum memasukkan memori kerja tambahan dan overhead perangkat lunak. Melalui dukungan memori yang besar, GPU D Series dapat membantu mengurangi kebutuhan membagi model ke beberapa akselerator pada beban kerja yang sesuai. Akan tetapi, kapasitas besar saja tidak menjamin inferensi lebih cepat. Kemampuan komputasi harus dievaluasi secara bersamaan ketika merancang infrastruktur pusat data.
Infrastruktur AI dengan Perangkat GPU yang Lebih Mudah Diintegrasikan
Di samping menawarkan kemampuan inferensi, Intel menekankan efisiensi penerapan dengan infrastruktur pusat data yang sudah tersedia. GPU D270 dirancang untuk pengoperasian melalui pendinginan udara dengan daya sekitar 350 watt. Sistem pendinginan yang digunakan dirancang agar mendukung penggunaan pada infrastruktur enterprise. Tidak seperti konfigurasi yang mengharuskan infrastruktur liquid cooling, desain tersebut membantu menyederhanakan proses penerapan. Namun demikian, pengelolaan temperatur tetap membutuhkan perencanaan agar perangkat bekerja secara stabil.
Dari sisi konektivitas, Intel GPU D Series menggunakan antarmuka PCIe 5.0. Teknologi interkoneksi ini menyediakan jalur transfer antara GPU dan komponen server. Melalui penggunaan koneksi yang sudah dikenal industri, Intel ingin mempermudah evaluasi perangkat oleh perusahaan. Perlu dipahami bahwa, pemasangan GPU tetap memerlukan pemeriksaan sistem. Aspek yang perlu diperhatikan meliputi ketersediaan suplai listrik, dimensi slot ekspansi, dan kapasitas aliran udara. Untuk memastikan penerapan yang tepat, tim teknis dianjurkan menilai kondisi sistem sesuai spesifikasi perangkat.
Ekosistem PyTorch dan vLLM pada GPU D Series
Manfaat nyata GPU pusat data memerlukan dukungan selain kemampuan komputasi. Framework komputasi yang didukung berperan penting dalam menjalankan model AI secara efisien. Untuk mendukung kebutuhan tersebut, Intel menekankan pendekatan software terbuka. Produsen semikonduktor ini memperkenalkan dukungan dengan PyTorch dan vLLM untuk mengembangkan aplikasi AI generatif. Dukungan tersebut dirancang agar membantu pengembang dalam mengoperasikan aplikasi berbasis AI tanpa harus menggunakan satu pendekatan perangkat lunak khusus.
Framework PyTorch dikenal sebagai platform pembelajaran mesin yang banyak digunakan untuk mengembangkan aplikasi kecerdasan buatan. Di sisi lain, vLLM berfokus pada penyajian model bahasa besar dengan optimalisasi throughput serta penggunaan cache. Dengan menghadirkan kompatibilitas perangkat lunak, GPU D Series dirancang agar sesuai untuk sejumlah skenario implementasi AI. Namun demikian, kemampuan menjalankan perangkat lunak tetap membutuhkan evaluasi. Pengelola sistem dianjurkan menguji kompatibilitas library, operator komputasi yang tersedia, serta efisiensi komputasi dalam penggunaan produksi sebelum menerapkan layanan AI berskala besar.
Peluang Infrastruktur Kecerdasan Buatan melalui GPU D Series
Pengenalan akselerator AI terbaru Intel menunjukkan strategi perusahaan dalam menghadirkan infrastruktur inferensi AI yang memprioritaskan efisiensi pemrosesan. Dukungan LPDDR5X hingga 480 GB, bandwidth hingga 1,5 TB/s, dan kemampuan teoritis 1,3 petaflops dalam format FP8 menawarkan potensi menarik untuk menjalankan model bahasa besar. Di samping kemampuan teknisnya, penggunaan antarmuka PCIe 5.0 memberikan pilihan integrasi bagi perusahaan. Walaupun spesifikasinya menjanjikan, efisiensi aktual harus dinilai berdasarkan aplikasi sebelum menentukan manfaat ekonominya. Seberapa menarik menurut Anda perkembangan TEKNOLOGI komputasi AI Intel? Mari sampaikan pandangan Anda mengenai masa depan infrastruktur kecerdasan buatan.